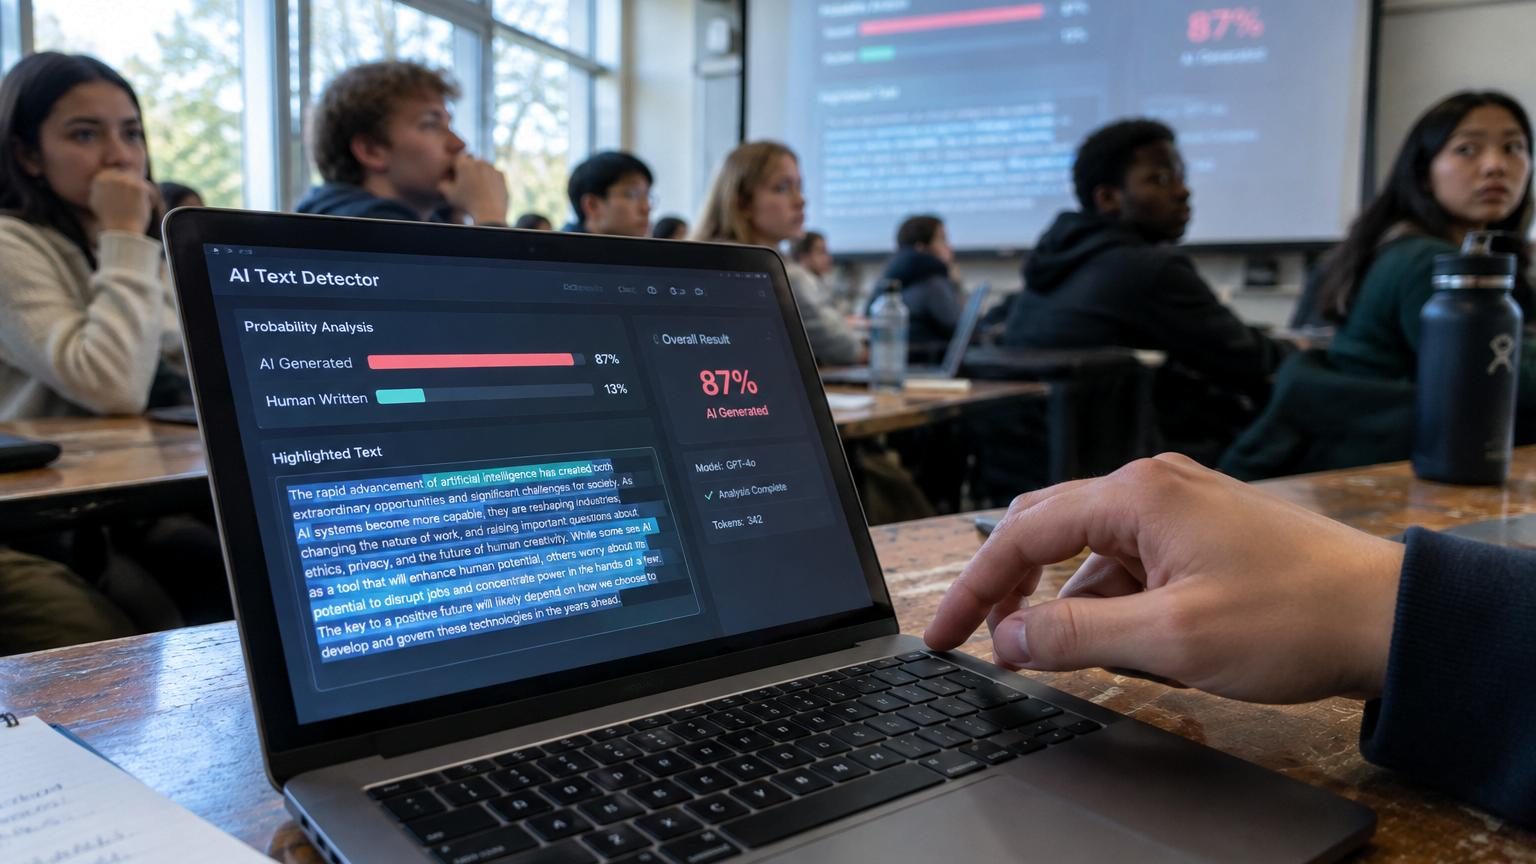
Le curseur clignote sur l’écran, le site de détection d’IA est ouvert et le texte défile : « I have a dream… ».
Dans la pièce, un silence étrange s’installe, celui qu’on ressent quand l’histoire rencontre la technologie. D’un côté, les mots de Martin Luther King, vibrants, imparfaits, profondément humains. De l’autre, une interface froide, avec un pourcentage qui doit trancher : texte humain ou texte généré par une machine.
Nous connaissons tous ce moment où l’on attend un verdict numérique, sans trop savoir pourquoi notre ventre se serre. Le score apparaît : « Probablement généré par une IA ». Stupeur. Malaise. Puis quelqu’un efface un seul mot dans le discours. Un mot banal, presque invisible. Le résultat se renverse aussitôt : « Probablement écrit par un humain ». Une phrase s’impose alors, un peu brutale : et si nos outils ne comprenaient pas vraiment ce qu’est une voix humaine ?
Quand un algorithme doute de Martin Luther King
Tout part d’une expérience quasi enfantine : copier-coller le discours « I Have a Dream » dans un détecteur d’IA gratuit. Rien que ce geste en dit long sur notre époque. Face à l’écran, on regarde ces phrases prononcées en 1963 comme si elles étaient un simple texte anonyme, à analyser, à découper, à juger. Le logiciel mouline quelques secondes, les barres de couleurs se remplissent, et soudain, ce moment fondateur de la lutte pour les droits civiques se retrouve rangé dans la case *suspect*.
Un chercheur, intrigué, décide alors de jouer avec les limites de l’outil. Il enlève un mot dans le tout début du discours, un adverbe presque anodin. Rien qui change le sens. Rien qui changerait l’émotion d’un auditeur humain. Sur l’écran, pourtant, tout bascule : le pourcentage de « texte IA » s’effondre, l’analyse affiche désormais une forte probabilité d’auteur humain. Une toute petite modification, un verdict totalement différent. On pense à ces copies d’élèves, à ces mails de candidatures, à ces posts sur les réseaux sociaux qui pourraient être jugés sur cette même base fragile.
Ce jeu du mot en moins met en lumière une réalité dérangeante. Ces détecteurs ne lisent pas un texte comme nous le faisons, ils n’entendent ni la voix de Luther King ni le souffle de la foule. Ils trient des probabilités, des schémas de phrases, des rythmes. Ils évaluent si le texte ressemble statistiquement à ce que produisent les IA actuelles. *Pas s’il porte une vision, une colère, une espérance.* D’où ce paradoxe : le discours l’un des plus humains du XXe siècle peut, selon un outil, « ressembler » à ce qu’écrirait une machine entraînée sur des millions de pages.
Le piège des tests d’IA dans la vraie vie
Devant ce genre d’expérience, la tentation est grande de se dire : supprimons tous ces détecteurs, ils ne servent à rien. La réalité quotidienne est moins simple. Des enseignants les utilisent pour vérifier des devoirs, des recruteurs pour repérer des lettres de motivation trop parfaites, des médias pour filtrer des textes suspects. Chacun essaie de garder la tête hors de l’eau face à la vague de contenus générés automatiquement. Personne n’a le temps de tout lire, vraiment lire, phrase après phrase.
Le risque, c’est que ces outils deviennent un réflexe rassurant, presque un totem. On colle un texte, on regarde un pourcentage, on se sent protégé. On oublie que ces scores sont approximatifs, qu’ils varient selon la longueur du texte, son style, son niveau de langue. Un discours historique comme celui de Martin Luther King se retrouve traité comme un devoir de lycée un peu trop bien écrit. Soyons honnêtes : personne ne passe ses soirées à vérifier la marge d’erreur de ces sites avant de cliquer sur « analyser ».
Cette légèreté a un prix. Quand un détecteur se trompe sur MLK, c’est gênant, mais ça reste une démonstration. Quand le même type d’outil se trompe sur un étudiant boursier, un demandeur d’emploi ou un auteur débutant, les conséquences sont bien plus concrètes. Une accusation de triche, un dossier mis de côté, un texte refusé. La ligne est fine entre la prudence et la méfiance généralisée. On le sent bien : s’appuyer uniquement sur ces scores, c’est déléguer notre jugement humain à des probabilités qui ne connaissent ni la nuance, ni le contexte, ni l’intention.
Comment utiliser ces détecteurs sans leur obéir
La première chose à faire, c’est de changer le statut mental qu’on donne à ces outils. Un détecteur d’IA ne devrait jamais être un juge, seulement un indicateur. *Un feu orange, pas un carton rouge.* Si le score semble suspect ou trop tranché, la vraie réaction utile consiste à relire le texte avec ses propres yeux, en se posant quelques questions concrètes : est-ce que le style est uniforme du début à la fin, sans aucune aspérité ? Y a‑t‑il des formulations étrangement neutres, presque lisses, qui sonnent faux ?
Une autre habitude saine consiste à recouper. Utiliser deux détecteurs différents, comparer les résultats, regarder comment la note évolue si l’on coupe le texte en plusieurs morceaux. Ce n’est pas pour « piéger » le système, mais pour voir à quel point le verdict est stable ou fragile. Quand un simple retrait de mot suffit à tout faire basculer, comme pour « I Have a Dream », cela révèle surtout la limite de l’outil. On se rend compte qu’on est face à un thermomètre capricieux, pas face à un expert littéraire.
Le piège classique, c’est d’affronter quelqu’un avec un screenshot de score, comme une preuve irréfutable. C’est humain, on aime les chiffres, les pourcentages en gros caractères. Pourtant, réduire un texte à 87 % IA ou 63 % humain, c’est oublier que l’écriture, c’est aussi la fatigue, l’inspiration du jour, les tournures héritées de nos lectures. Un élève timide peut soudain écrire un paragraphe magnifique. Un professionnel peut produire un texte plat un jour de rush. Le détecteur, lui, ne voit que les patterns. **Un bon réflexe consiste à parler du texte avec son auteur avant de le juger.**
Les travaux de chercheurs le montrent de plus en plus : ces outils sont biaisés, souvent entraînés sur des corpus limités, parfois plus sévères avec certains styles ou certaines langues. Un enseignant racontait récemment avoir testé plusieurs discours célèbres. Il en a tiré une conclusion simple, presque brutale :
« Si l’algorithme peut se tromper sur Martin Luther King, il peut se tromper sur mon élève de 16 ans. La différence, c’est que MLK ne perdra pas de points pour ça. »
Face à cette réalité, quelques repères concrets aident à garder le contrôle :
- Traiter tout score de détecteur comme une hypothèse, jamais comme une preuve formelle.
- Toujours combiner l’avis de la machine avec une lecture humaine, même rapide.
- Exiger de soi-même une explication argumentée avant d’accuser quelqu’un de triche.
- Se souvenir qu’un texte fluide, bien structuré, n’est pas automatiquement « suspect ».
- Accepter qu’une part d’incertitude fait partie du jeu, et que **zéro risque d’erreur n’existe pas**.
Et si la vraie question n’était pas « IA ou humain », mais « à quoi servent nos mots » ?
Cette histoire de mot effacé dans « I Have a Dream » laisse un drôle de goût. On touche à quelque chose de très contemporain : l’obsession de tout mesurer, même ce qui échappe aux chiffres. Un discours qui a fait trembler Washington en 1963 se voit réduit à un score de probabilité en 2026. On clique, on commente, on s’indigne un peu, puis on passe à autre chose. Comme si cette confusion entre voix humaine et texte statistique n’allait pas, tôt ou tard, nous retomber dessus.
On peut retourner la question : si nos écrits deviennent si prévisibles que des IA peuvent les imiter sans effort, n’avons-nous pas, parfois, aplati nos propres mots ? Phrases formatées, expressions toutes faites, mails copiés-collés, posts calibrés pour l’algorithme. Les détecteurs d’IA ne sont peut-être qu’un miroir déformant d’un autre phénomène : nos voix individuelles s’effacent derrière des manières d’écrire standardisées. Une lettre de motivation qui ressemble à toutes les autres, même écrite à la main, sonne déjà un peu « artificielle ».
La vraie marge de manœuvre se trouve peut‑être là. Dans notre façon de réintroduire du grain, des hésitations, des tournures personnelles. Pas pour tromper les algorithmes, mais pour exister à côté d’eux. Un discours comme celui de Martin Luther King traverse le temps parce qu’il porte un contexte, un corps, un moment. Aucun détecteur ne peut analyser la chaleur d’une foule dense sous le soleil, le timbre d’une voix qui tremble légèrement sur un mot, le silence qui suit une phrase juste. Nos textes quotidiens n’ont pas à être des discours historiques, mais ils peuvent, à leur échelle, garder cette petite chose qui ne s’efface pas avec un simple clic : une intention claire, un ton singulier, une vulnérabilité assumée.
| Point essentiel | Détail | Valeur ajoutée pour le lecteur |
|---|---|---|
| Les détecteurs sont approximatifs | Un seul mot retiré du discours « I Have a Dream » suffit à inverser le verdict IA/humain | Prendre conscience des limites techniques et éviter les jugements hâtifs |
| Le jugement humain reste central | Les scores doivent être combinés avec une vraie lecture, un échange, un contexte | Réduire les injustices pour les élèves, candidats ou auteurs évalués par ces outils |
| Retrouver une voix personnelle | Accepter les aspérités, les tournures singulières, les émotions dans l’écriture | Écrire des textes qui résistent mieux à la standardisation et racontent vraiment quelque chose |